Wie genau ist das Scannen von Nährwerttabellen? Getestet an 141 echten Etiketten
Die Nährwerttabelle zu fotografieren ist bequemer als Abtippen, bis eine Zahl falsch herauskommt. Wie oft das bei 141 echten Etiketten passiert und was du vor dem Speichern prüfen solltest.
Eine Nährwerttabelle abzutippen ist der mühsamste Teil beim Eintragen. Energie, Fett, gesättigte Fettsäuren, Kohlenhydrate, Zucker, Ballaststoffe, Eiweiß, Salz, dann noch die Portionsgröße, und die Packung balancierst du in der anderen Hand. Die Tabelle einfach zu fotografieren klingt da großartig. Bis eine Zahl falsch erkannt wird, denn eine Zahl, die du nicht selbst eingetippt hast, prüfst du nie nach.
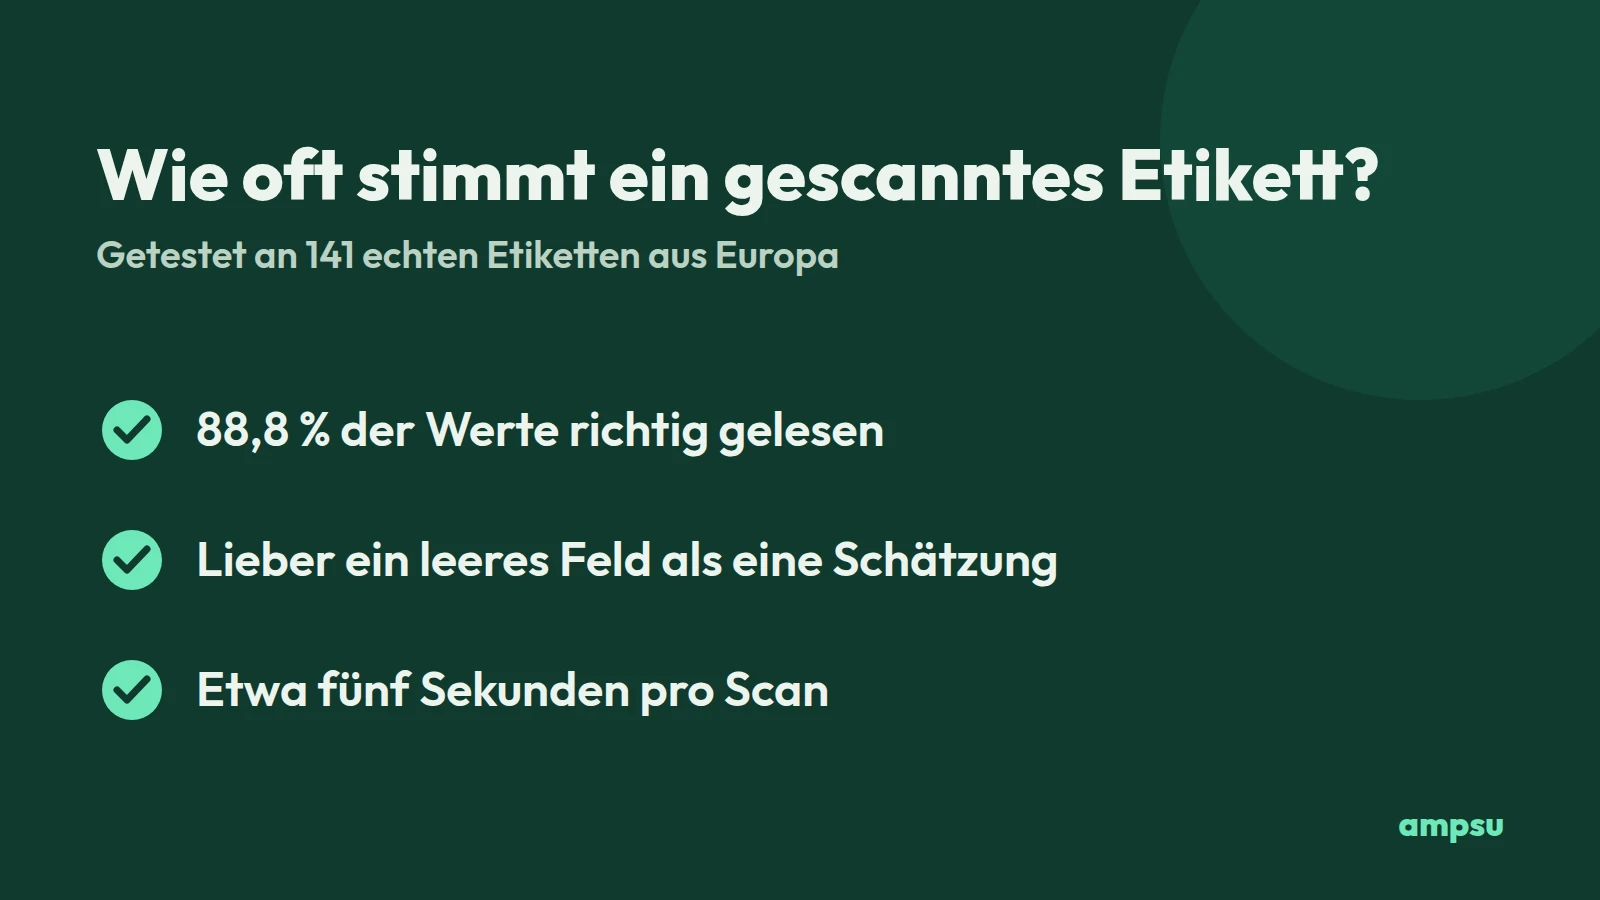
Die kurze Antwort: Bei 141 echten Etiketten hat der Etikettenleser von Ampsu 88,8 % der Werte richtig gelesen, 8,4 % falsch und den Rest leer gelassen, in etwa fünf Sekunden pro Scan. Das reicht, um dir das Tippen zu sparen, aber nicht, um vor dem Speichern nicht noch kurz draufzuschauen. Wie ich das getestet habe und was du mit den Zahlen anfängst, steht unten.
Wie wurde getestet?
Mit den Fotos, die man in Wirklichkeit macht. Ich habe 141 Fotos von Nährwerttabellen genommen, von Produkten aus ganz Europa, in vielen verschiedenen Sprachen. Manche sind scharf und gerade, manche zerknittert, schief oder etwas unscharf, also ungefähr so, wie es in einer Küche eben aussieht.
Jedes Foto lief durch denselben Code wie in der App, und jeder gelesene Wert wurde mit dem verglichen, was auf der Packung steht: Energie, Fett, gesättigte Fettsäuren, Kohlenhydrate, Zucker, Ballaststoffe, Eiweiß, Salz und dazu die Marke. Ein Haken dabei: Manche Vergleichswerte waren berechnet und nicht vom Etikett übernommen, etwa ein Kilojoule-Wert, der aus den Kilokalorien errechnet wurde. Die hätten eine richtige Lesung falsch aussehen lassen, also zählten nur Zahlen, die wirklich auf der Packung stehen.
Was kam heraus?
| Jetzt | Die Version davor | |
|---|---|---|
| Werte richtig gelesen | 88,8 % | 63,5 % |
| Werte falsch gelesen | 8,4 % | 22,9 % |
| Marke richtig erkannt | 87 % | 43 % |
| Zeit pro Scan | 5,0 s | etwa 29 s |
Die Version davor ist der erste Etikettenleser von Ampsu. Er war langsamer und hat fast ein Viertel der Werte falsch gelesen, deshalb gibt es ihn nicht mehr.
Warum ist ein leeres Feld besser als eine falsche Zahl?
Weil dir ein leeres Feld auffällt. Fehlen die Ballaststoffe, siehst du das sofort und trägst sie nach oder lässt es bleiben. Ein falscher Fettwert sieht genauso aus wie ein richtiger, wird gespeichert und landet still in jedem Tag, an dem du das isst.
Deshalb lässt der Etikettenleser einen Wert lieber leer, wenn er ihn nicht klar lesen kann, statt sich etwas auszudenken. Unmögliches gibt er dir auch nicht zurück, etwa mehr Zucker als Kohlenhydrate insgesamt. Im Zweifel bleibt eine Lücke für dich.
Kann ich mich darauf verlassen?
Beim Abtippen ja. Schau vor dem Speichern kurz auf die Energie und auf das, was dir am wichtigsten ist, bei vielen das Protein, und vergleich es mit der Packung. Das dauert ein paar Sekunden.
Und wenn du etwas jede Woche isst, prüf es einmal richtig und speicher es. Danach scannst du den Barcode statt des Etiketts, und die Werte sind die, die du schon kontrolliert hast.
Wie bekomme ich ein gutes Ergebnis?
- Leg die Packung flach hin oder halt sie so, dass die Tabelle nicht um eine Rundung gebogen ist.
- Nimm die ganze Tabelle mit aufs Bild, samt Spaltenüberschriften, damit klar ist, welche Spalte pro 100 g ist.
- Kipp sie ein wenig, wenn es spiegelt. Eine glänzende Verpackung unter der Küchenlampe ist der häufigste Grund, warum ein Wert fehlt.